Multi-source data-driven model to predict the deposition rate of CVD-SiC coatings with improved accuracy and robustness
多源数据驱动模型:提升 CVD-SiC 涂层沉积速率预测的精度与稳健性
Journal of the American Ceramic Society · 2025, 108, e20616 · doi:10.1111/jace.20616
📌 核心要点
- 把文献数据、多物理场仿真数据与少量实验数据整合为多源数据集(3345 个文献数据点 + 320 条仿真数据),用于预测 CVD-SiC 涂层沉积速率。
- 提出模拟填充法 SBF(simulation-based filling)解决文献数据特征缺失问题,将预测误差 MAPE 从 12% 降至 3%,最优模型为 GBDT 配合随机森林插补,R² 达 0.9853。
- 引入仿真数据后,模型在多物理场边界条件之外的 R² 仍提升至 0.9746,说明精度增益并非只在训练域内成立,泛化与稳健性同步改善。
- Sobol 全局敏感性分析定量确认温度是主导参数:直接贡献 63% 的输出方差,计入交互效应后达 78%;停留时间与 Qmts 通过交互被放大。
- 模型可解释性输出(Mantel 检验、特征重要性、SHAP)与 CVD 物理机理一致,并支持逆向参数优化 IPO,为实验提供正向引导、降低试错成本。
概览:为什么 CVD-SiC 需要数据驱动模型
SiC 作为第三代半导体材料,凭借高热导率、高电子迁移率、高击穿场强和化学稳定性,在功率电子与航空航天领域被广泛使用,而这些性能最终取决于能否稳定制备高质量的 SiC 涂层与薄膜。CVD 因为均匀性好、纯度高、化学计量比可控,成为 SiC 涂层的首选工艺。作者列举了涂层带来的结构收益:Zhao 等用 LPCVD 在碳纤维上制备可控 SiC 涂层增强羟基磷灰石复合材料,0.5 wt% 的 SiC-CF 添加量使抗弯强度升至 28.4 MPa,约为同条件纯 HA 的三倍;Wen 等发现未涂层 PIP-C/SiC 复合材料失重 29.2%、仅保留 6.74% 的弯曲强度,而涂层样品失重 10.2%、保留 23.4%;Zhan 等用 C 形环状试样证明 CVD-SiC 涂层及其与 SiCf/SiC 的界面能有效保护复合管材。
问题在于 CVD 工艺本身:周期长、成本高,温度、压力、气体流量等变量高度耦合,导致工艺优化和重现性都很困难。已有的两条解决路径各有短板。多物理场仿真方面,Bijjargi 等建立含压缩输运与反应机理的 3D 模型,Ogawa 等在 CH3SiCl3/H2 体系中把 MTS 分解模型与 SiC 生长模型耦合,Cao 等用 CFD 系统考察石墨板布置、直径、沉积温度、反应气流量与转速,Zou 等用多孔介质方法分析工业级多基体反应器;这类方法计算昂贵且依赖专家知识。机器学习方面,Kimaev 等用 ANN 建模薄膜粗糙度与生长速率,Rajak 等用离线强化学习预测单层 CVD-MoS2 的合成日程,Xu 等用监督学习指导准一维 WTe2 纳米带合成,Costine 等则手工构建 MoS2 文献数据库来提取趋势;共同瓶颈是训练数据稀缺。
本文立场:材料行为遵循物理规律,这些规律会在实验数据中留下可识别的模式。数据驱动方法不需要完整的机理表达就能隐式提取这些模式,但其有效性取决于数据代表性、特征选择合理性与模型结构适配性。因此作者不追求单一大数据集,而是用多源数据 + 模拟填充法把仿真的精度、实验的真实性与机器学习的效率组合起来。
多源数据集与模拟填充法 SBF
CVD 工艺参数可归为前驱体参数、反应器参数、基体参数与生长参数四类,它们共同描述整个沉积过程并构成模型输入。作者从公开文献中提取了 3345 个数据点,但由于各研究的内容与设备差异,特征缺失不可避免,而不完整的特征会直接拖累模型性能。为此提出 SBF 方法,实施分四步:先做典型 CVD-SiC 实验获得实验数据;再对反应器建模并用实验数据标定模型参数;然后对模型做参数扫描,得到特征完整的仿真数据;最后用这批完整数据填补缺失值。
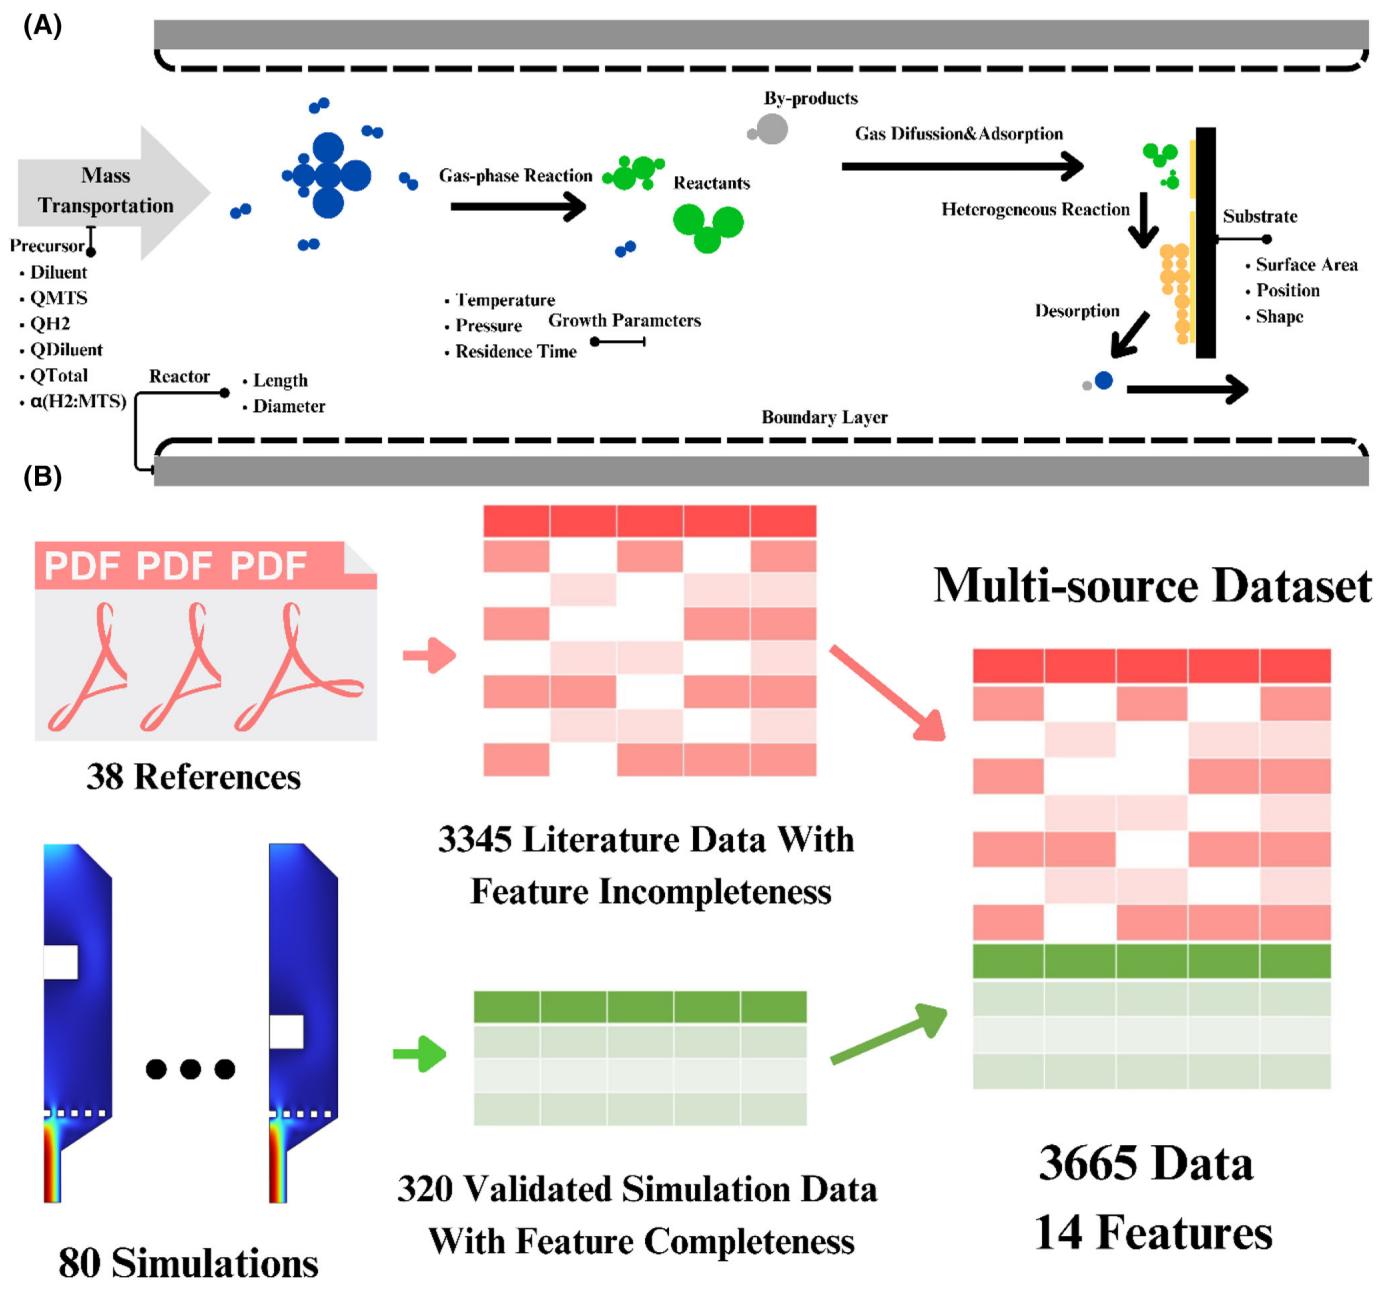
实验与多物理场模型
实验以直径 20 mm、厚 10 mm 的蜂窝石墨块为沉积基体,经抛光、超声清洗、干燥后使用;MTS 为源气体,H2 为载气,Ar 为稀释气,反应室为 Φin42 × Φout46 × 60 mm 的圆柱腔体,沉积温度 1573–1673 K,压力 6–24 kPa,α(H2:MTS)5–20。仿真采用热-流-化耦合模型,求解连续性方程、动量方程、能量方程与组分输运方程,混合气密度由理想气体状态方程给出。基体-气体界面施加完整边界条件:动量方向用无滑移壁面(u = 0, v = 0),组分方向用耦合表面反应与体相扩散的通量边界 −Di∇ci = Ri,并对边界层网格加密、通过网格无关性验证保证近壁面陡峭的温度与浓度梯度被分辨。
气相与表面反应被简化为四步机理:CH3SiCl3 → CH3 + SiCl3;2SiCl3 + H2 → 2SiCl2 + 2HCl;2CH3 → C2H4 + H2;C2H4 + 2SiCl2 → 2SiC(ads) + 4HCl。指前因子与活化能先由文献估计,再对照实验沉积速率迭代优化,直到总体误差降到 15% 以下。作者坦承这种简化的代价:难以预测细节的微观结构演化,极端条件下次要路径与瞬态现象表达不足,但对典型工况下沉积速率这一目标影响很小。
插补方法的统计评估
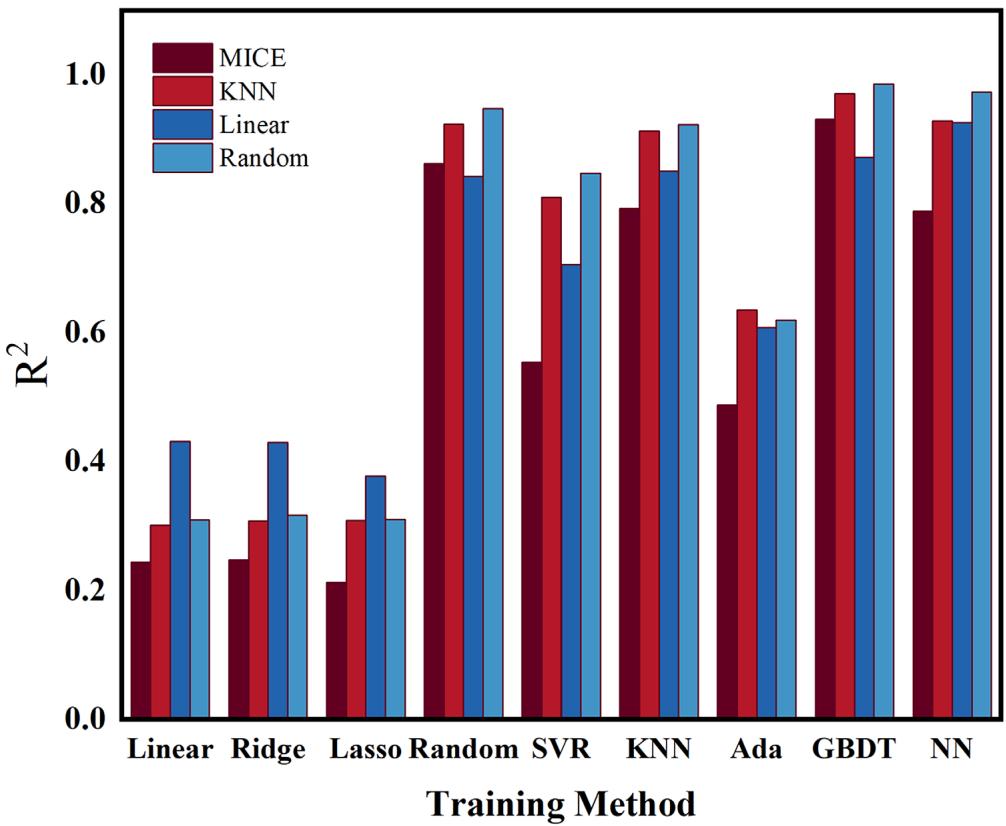
作为对照,作者同时评估了简单插补(均值、中位数、众数)、MICE(贝叶斯链式方程多重插补,迭代 300 次以保证收敛)、线性回归插补、KNN 回归插补与随机森林回归插补,并指出回归类插补只有在特征完整时才有效。整个评估构成 63 种组合(7 种插补方法 × 9 种训练模型)的比较矩阵,性能一律用五折交叉验证衡量,从而把插补误差向下游建模的传播显式量化。
机器学习建模、超参数优化与可解释性工具
训练模型覆盖线性族(Ridge、Lasso、线性回归)、近邻法(KNN)、支持向量回归 SVR、集成学习(Random Forest、AdaBoost、GBDT)与神经网络(PyTorch 实现)。针对气体流量之间可能存在的共线性,作者按模型类型分别处理:线性模型用 Ridge 与 Lasso 正则化抑制多重共线性,神经网络加入 Dropout 层防止对共线特征过拟合,树模型则依靠分裂机制隐式完成特征选择。超参数通过随机搜索在给定空间内采样,例如 RandomForestRegressor 搜索 n_estimators(10–200)、max_features、max_depth(3–20)等,SVR 搜索 C、kernel、gamma,PyTorchRegressor 搜索 hidden_dim(16–256)、层数(1–5)、激活函数、优化器、学习率与 batch size。
| 环节 | 做法 | 作用 |
|---|---|---|
| 数据划分 | 随机打乱后划分为训练/验证/测试集,配合五折交叉验证,共 50 次训练迭代 | 削弱非均匀分布带来的评估偏差 |
| 评价指标 | MAPE 与 RMSE,并以五折交叉验证后的 R² 排序模型 | 同时刻画相对误差与误差量级 |
| 相关性分析 | Mantel 检验:构造两组距离矩阵,计算相关系数并随机置换行列标签重复检验,Mantel's p < 0.05 判为显著 | 识别参数间非随机关联 |
| 特征归因 | SHAP(基于 Shapley 值)与特征重要性排序 | 量化每个特征对预测的正负贡献 |
| 全局敏感性 | Sobol 指数(S1 一阶、ST 总计) | 把参数影响分解为直接贡献与交互贡献 |
| 逆向优化 | IPO:在输入空间搜索使预测输出最大的参数组合,含动态迭代缩放与停滞检测 | 把预测模型反转为工艺设计工具 |
IPO 之所以选随机搜索而非梯度法,理由很实际:参数空间混合了连续量与离散量,非凸优化容易陷入局部极大,模型本身是黑箱且梯度计算不便,随机采样在结构多样性上更稳定。选模依据是 R² 评估,终止条件为达到最大迭代次数或连续 10 次迭代无显著改进,当性能提升超过 70% 时自动加大搜索强度。
精度对比:MAPE 从 12% 降到 3%
先看数据本身。对数尺度的沉积速率分布明显右偏,均值 24.19 大于中位数 6.25,标准差与极值都很大;KDE 曲线与累积分布函数显示数据集中在低值区,少数高值离群点把均值抬高。这意味着模型必须在稀疏的高速率区域也保持可靠。
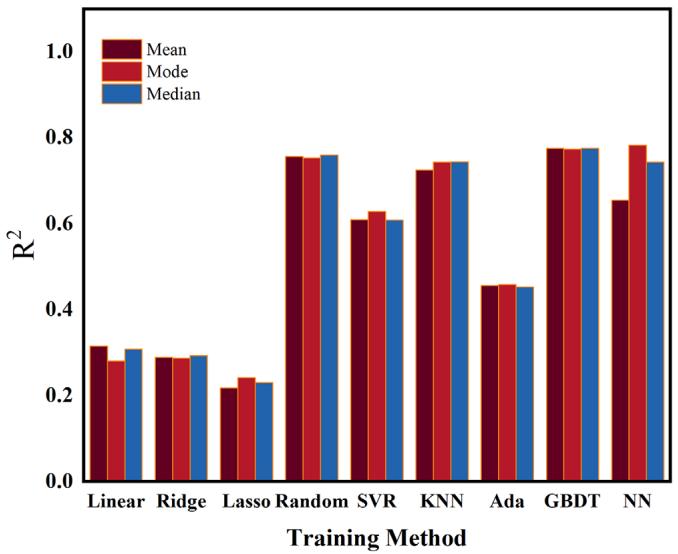
只用简单插补时,训练结果分成三档:Random Forest、KNN、GBDT 与 NN 的 R² 在 0.8 附近;SVR 与 AdaBoost 低于 0.6;线性回归、Ridge、Lasso 低于 0.4。均值、众数、中位数三种策略对最终性能影响不大,最好的是众数插补下的 NN 模型,R² 为 0.783。用它对实验值拟合,R² 为 0.7986、MAPE 为 12%。这个偏高的误差正是简单插补的局限:计算简单,却忽略真实分布特征、压缩了变异性,也无法捕捉多变量之间的相关性。
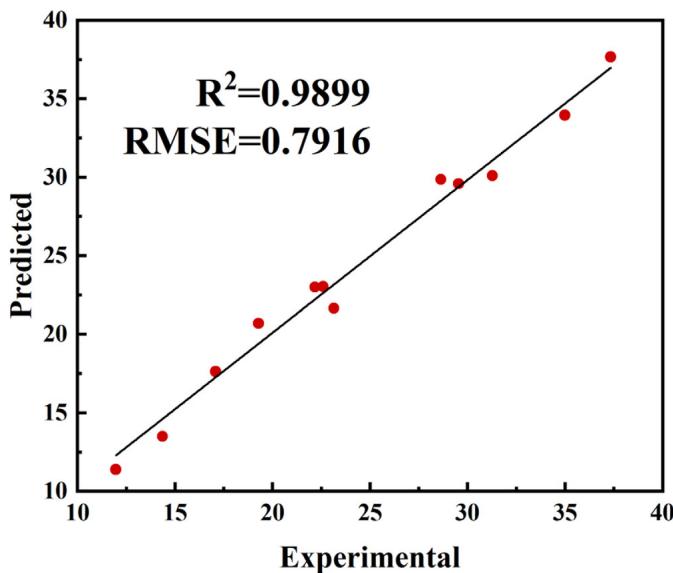
转向 SBF。作者先用优化后的多物理场模型在典型边界条件下复现实验,得到 R² 0.9735、MAPE 4%,证明仿真本身可信;随后在数据稀疏区扩展仿真(温度 1173–1573 K、压力 6–12 kPa、α 6–15),生成 320 条特征完整的数据,再用多种回归策略完成缺失值填补。结果显著改善:最佳组合是随机森林插补 + GBDT,R² 达 0.9853,MAPE 降到 3%;该模型对实验数据的拟合 R² 进一步提升到 0.9899。
简单插补
计算开销极低,但忽略真实分布、压缩变异性、无法表达变量间相关性;最佳 R² 0.783,对实验拟合 MAPE 12%。
模型基插补(SBF)
用回归方程刻画数据点间复杂关系,非线性表达更准;泛化更好,正则化抑制噪声与离群点,特征关系更透明;最佳 R² 0.9853,MAPE 3%。
稳健性、Sobol 敏感性与特征重要性
训练集由仿真数据与文献数据混合构成,且仿真数据的边界条件 Csimulation 是文献数据边界条件 Cliterature 的子集。为检验模型是否只是在内插区间表现好,作者专门在边界条件之外(即 Cliterature 中 Csimulation 的补集)比较引入仿真数据前后的拟合。结果显示,引入仿真数据后边界外 R² 也提升到 0.9746,说明多源数据带来的不只是精度,还有外推能力的增强。
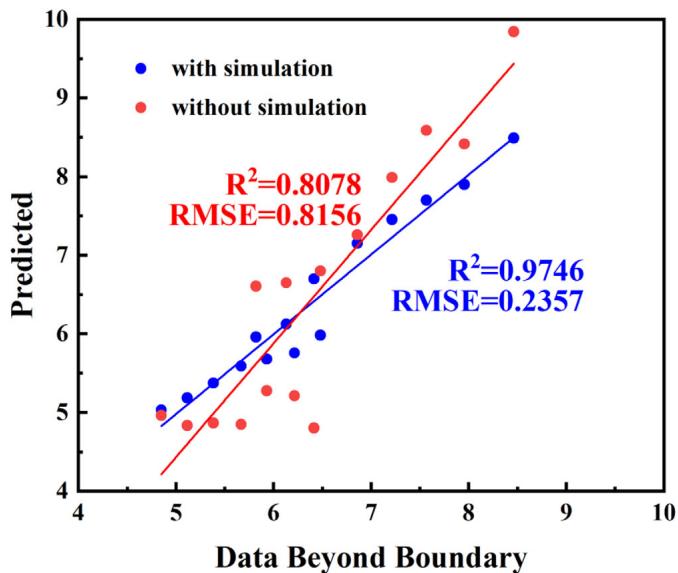
残差统计进一步支撑可靠性判断:系统误差(bias)为 0.0342,表明仅有极轻微的速率高估倾向;随机误差为 0.7974,预测波动小;Shapiro-Wilk、Kolmogorov-Smirnov 与 Anderson-Darling 三项检验的 p 值均大于 0.05,残差服从正态分布。
Sobol 敏感性分析给出定量结论:温度 S1 = 0.63、ST = 0.78,即直接解释 63% 的输出方差,计入交互效应后达 78%;停留时间(S1 = 0.07、ST = 0.10)与 Qmts(S1 = 0.06、ST = 0.16)的影响主要通过交互被放大;压力、基体位置、Qtotal、反应器长度等合计贡献不足 10%。这与 CVD-SiC 工艺中温度主导的实践经验一致,也说明模型学到的是物理主导结构而非伪相关。
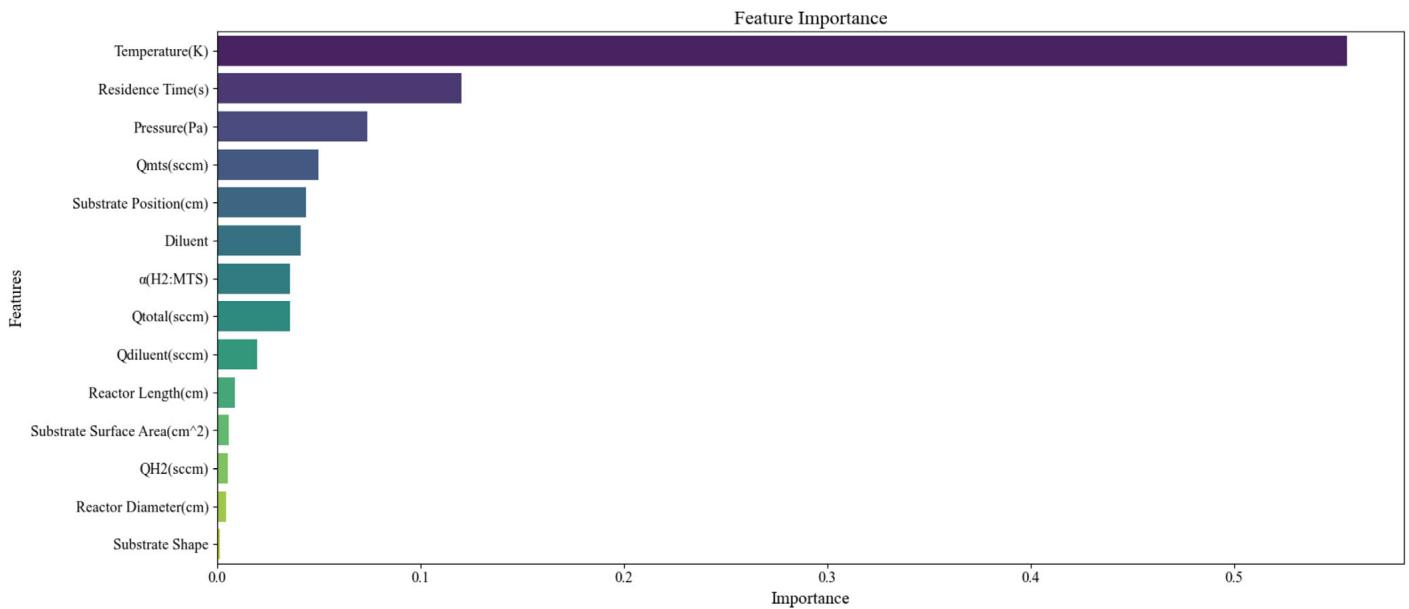
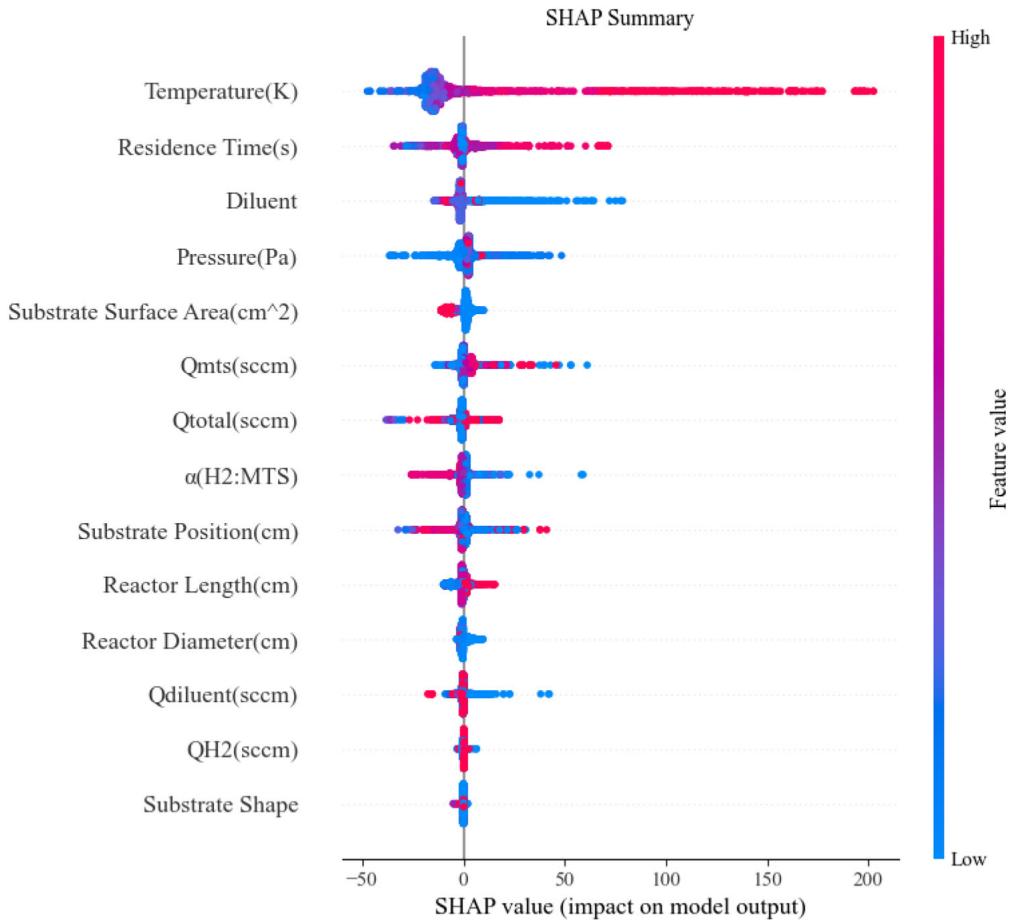
Mantel 检验的热图则解释了为什么某些流量特征重要性偏低:QH2、Qdiluent 与 Qtotal 之间存在强相关,因为 CVD 工艺中气体流量通常按固定配比优化,组分比例稳定导致高度共线;与沉积速率统计显著的参数用橙色线标注,线宽代表相关强度。SHAP 结果给出了温度的双向作用:较低温度下适度升温有利于 SiC 晶体成核与生长、减少杂质与缺陷,此时温度是有益因素;温度过高则副产物、杂质与缺陷增多,抑制成核并降低涂层质量。这种由正转负的效应转变,正是工艺优化中必须精确控温的理由。
模型在不同基体几何与位置上的误差也给出了泛化边界:圆形 2.43%、矩形 2.91%、方形 2.86%、喷嘴 3.36%,简单几何略优;基体位置 2、3、4、5 cm 的误差分别为 2.68%、3.03%、2.92%、2.19%,均处于低位;在动力学到传质的过渡区 1473–1573 K 内 R² 达 0.9910、MAPE 2.86%,复杂几何如喷嘴仍有改进空间。
从模型回到机理:停留时间、压力与逆向优化
模型输出的第二个价值,是把参数影响翻译成可检验的工艺机理。停留时间定义为反应气流过基体表面的时间,τ = (V/Q)·(T0/T)·(P/P0),其中 V = πr²·L 为有效体积、L 为基体位置、Q 为反应气流量,T0 = 298 K、P0 = 101 kPa。它同时受基体位置、流量、温度与压力影响,停留时间不同则反应程度不同,气相组分的种类与浓度随之改变,最终影响制备材料的性能,因此也可称为有效反应时间。
为提取这一关系,作者对层流假设下的仿真数据做分箱拟合:先用自适应分箱(默认 50 箱)求均值以滤除高频噪声,再构造最高 30 阶的多项式特征并做长度校验与 NaN 检测,最后用 R² 评估各阶复杂度。R² 随阶数先升后降,在第 12 阶达到峰值约 0.686,到第 30 阶跌到 0.232,中间在第 16 与 20 阶出现小幅波动但不改变整体下行趋势,说明高阶模型开始拟合噪声。这里的关键是用分箱实现空间正则化,而不是常规数学正则化。所得沉积速率与停留时间的关系为 R = Σ aiτi(i = 1 到 12),R 单位 μm/h、τ 单位 s。
压力为何存在上限:腔内压力升高会缩短反应分子平均自由程、提高碰撞频率,通常加快反应;但压力升高同时带来反应副产物累积。若沉积受表面化学反应控制,按 Langmuir 等温吸附 θi = Ki·θ·Pi,总压上升会提高反应物浓度、表面吸附量与沉积速率;一旦基体表面活性位点饱和,浓度继续增加也不再改变沉积速率,速率转为恒定。这与 Sobol 结果中压力直接贡献有限相吻合。
反应器几何的影响同样能在浓度场中找到解释。仿真中中间气体(C2H4 与 SiCl2)在基体区域变化最剧烈:一方面基体阻碍气体输运,使远离入口的表面浓度偏低;另一方面表面反应消耗中间气体,吸附、迁移、反应、脱附在不同工况下控制机制不同,形成显著浓度梯度。基体在加热区中的位置会制造浓度梯度与温度梯度,较大的表面积在反应物供给有限时导致膜厚不均,较小的反应器半径则有利于流场、温度场与浓度场均匀,而反应器长度与基体形状影响较小。把这些机理链条接起来,IPO 就不再是盲目搜索:它是在一个已被物理规律约束的参数空间中寻找使沉积速率最大化的参数组合。
结论与展望
核心结论:作者用文献数据、与实验拟合的数值仿真结果共同构成多源数据集,训练出可预测 CVD-SiC 沉积速率的机器学习模型。SBF 模拟填充法把预测误差从 12% 降到 3%,并在多物理场边界条件之外把 R² 提升到 0.9746;Sobol 全局敏感性分析确认温度主导输出方差(直接 63%、含交互 78%),为 CVD-SiC 的实验观察提供了定量验证。
方法层面的可迁移点
- 多源数据(文献 + 仿真 + 实验)是缓解小样本工艺数据瓶颈的现实路径。
- 缺失值处理应作为建模的一部分被评估,而不是预处理细节。
- 可解释性工具(SHAP、Mantel、Sobol)是把黑箱预测转回机理认知的桥梁。
下一步方向
- 把涂层均匀性、微观组织与力学性能纳入多目标优化目标。
- 改进喷嘴等复杂几何下的预测精度。
- 用模型对实验做正向引导,降低试错成本、提高工艺开发效率。
这项工作的意义不止于一个更准的沉积速率预测器,而在于给出一条可复制的路线:当实验数据昂贵而稀缺时,用受实验约束的仿真去补全数据,再用可解释的机器学习把数据还原成机理与工艺建议。
[精选]参考文献
- Liu R, Song C, Lu Z, Guan K, et al. Multi-source data-driven model to predict the deposition rate of CVD-SiC coatings with improved accuracy and robustness. Journal of the American Ceramic Society, 2025;108:e20616. doi:10.1111/jace.20616
- Zhao XN, Wang XD, Xin H, et al. Controllable preparation of SiC coating protecting carbon fiber from oxidation damage during sintering process. Applied Surface Science, 2018;450:265-73.
- Wen J, Zhou S, Yi L, et al. Oxidation behavior and high-temperature flexural property of CVD-SiC-coated PIP-C/SiC composites. Ceramics International, 2018;44:16583-88.
- Ogawa T, Fukumoto K, Machida H, Norinaga K. CFD simulation of CVD reactors in the CH3SiCl3(MTS)/H2 system using a two-step MTS decomposition and one-step SiC growth models. Heliyon, 2023;9:e15061.
- Morgan D, Jacobs R. Opportunities and challenges for machine learning in materials science. Annual Review of Materials Research, 2020;50:71-103.
- Costine A, Delsa P, Li T, Reinke P, Balachandran PV. Data-driven assessment of chemical vapor deposition grown MoS2 monolayer thin films. Journal of Applied Physics, 2020;128:235303.
- Shah AD, Bartlett JW, Carpenter J, et al. Comparison of random forest and parametric imputation models for imputing missing data using MICE: a CALIBER study. American Journal of Epidemiology, 2014;179:764-74.
- Pedregosa F, Varoquaux G, Gramfort A, et al. Scikit-learn: machine learning in Python. Journal of Machine Learning Research, 2011;12:2825-30.
补充说明:原文共 88 条参考文献,此处仅列出与汇报主线直接相关的条目,完整列表详见原文。