DeePMD-kit v2: A software package for deep potential models
DeePMD-kit v2:面向 deep potential 模型的开源软件包(机器学习势与分子动力学)
The Journal of Chemical Physics 159, 054801 · Submitted: 21 April 2023 · Accepted: 3 July 2023 · Published Online: 1 August 2023 · doi:10.1063/5.0155600
📌 核心要点
- DeePMD-kit 自 2017 年首发,v2 系列(文中为 v2.2.1)把 Deep Potential(DP)模型做成模块化组件:descriptor、fitting network、type embedding、modifier、trainer,全部映射为 TensorFlow 静态图加自定义 C++/GPU 算子。
- 模型谱系覆盖 local frame、two-body 与 three-body embedding DeepPot-SE、attention-based descriptor(DPA-1)、hybrid descriptor,并支持 tensile/tensorial 性质、DPRc、DPLR、model deviation、model compression 与 NVNMD。
- model deviation 驱动的 concurrent learning 是精度可控的关键:以模型集合的力标准差 ε_F,max 作为误差指标,用阈值区间筛选待标注构型,形成 training、exploration、labeling 闭环。
- 基准测试显示没有全能冠军:水体系 loc_frame 最准最快但不光滑且无 GPU 支持;多元素体系 se_atten 凭借 type embedding 在精度与显存上占优;模型压缩带来 1 至 10 倍加速与约 6 倍原子容量提升;NVNMD 在非冯诺依曼架构上快 50 至 100 倍。
- 可用性与生态是这一版的主打卖点:pip/Conda/Docker 预编译包、CLI 与 DP-GUI、Python/C++/C/header-only API,以及与 LAMMPS、i-PI、GROMACS、AMBER、OpenMM、ABACUS、ASE 的接口,配合 DeepModeling 社区形成完整工具链。
概览:把量子力学精度装进经典力场的计算成本
机器学习势(machine learning potentials, MLPs)近十年改变了分子动力学(MD)的格局:neural network potentials、message passing 模型以及其他机器学习模型,让原子尺度模拟第一次同时接近 ab initio 的精度和分子力学(MM)的效率。DeePMD-kit 是这条路线上最早也最成熟的开源实现之一,2017 年发布,此后由大量开发者共同推进,其实现的 Deep Potential(DP)模型已被用于金属、非金属无机材料、水、有机物、溶液、气相体系、大分子与界面,几乎覆盖元素周期表上的全部元素,并能在很宽的温度与压力范围内工作,包括类药分子、离子、过渡态乃至激发态。
三个代表性应用:其一是水相图,Zhang 等人用 DeePMD-kit 构建了覆盖 0 至 2400 K、0 至 50 GPa 的 deep potential 水模型,训练数据来自 SCAN 泛函的 DFT,在相关热力学区间内 RMSE 小于 1 meV/H2O,正确预测出流体、分子与离子相以及除 III 与 XV 之外的全部稳定冰多晶型,并解析了 ice VII 到 VII''、VII'' 到离子流体两个一级相变与质子扩散机制。其二是凝聚相长程相互作用,Zeng 等人提出 Δ-MLP 方法 DPRc,把线性标度的半经验 QM/MM 校正到 ab initio QM/MM 水平,用于 RNA 2'-O-transphosphorylation 溶液的长时标模拟,并借助 gwTP 方法获得更好的自由能估计。其三是纳秒级反应 MD,1 ns 甲烷燃烧中识别出 798 个不同化学反应,随后扩展到直链烷烃热解、炸药分解与多环芳烃生长。
与初版相比,v2 的功能清单已经大幅扩张:DeepPot-SE、attention-based 与 hybrid descriptor、张量性质拟合、type embedding、model deviation、Deep Potential-Range Correction(DPRc)、Deep Potential Long Range(DPLR)、自定义算子的 GPU 支持、模型压缩、non-von Neumann molecular dynamics(NVNMD),以及文档、预编译二进制包、图形界面与 API 等易用性改进。本文(软件类研究文章,属 JCP 原子尺度机器学习软件专题)按组件、实现、应用、基准的顺序把这些能力串成一条完整脉络。
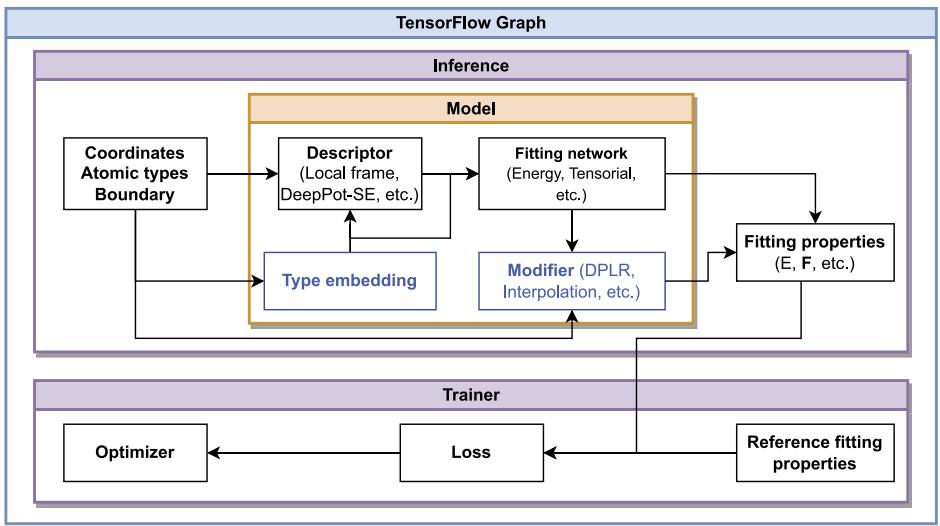
模型骨架:descriptor 加 fitting network 的原子分解
DP 模型的核心假设是局域性:第 i 个原子的贡献 y_i 只取决于自身坐标与化学种类 x_i 及其截断半径内邻居的集合,即 y_i = F(D(x_i, {x_j}_{j∈n(i)}; θ_d); θ_f),系统总量由 y = Σ_i y_i 给出。descriptor D 把原子环境编码成矩阵,fitting network F 把它映射为标量或张量。邻居数上限 N_c 对所有帧取同一常数,不足则补零。神经网络层支持 ResNet 风格的 skip connection(N_2 = N_1 或 N_2 = 2N_1 两种形式),激活函数提供 tanh、ReLU、ReLU6、softplus、sigmoid、GELU 与 identity,其中 ReLU 与 ReLU6 一阶导不连续,其余二阶导连续,这直接影响力与 virial 的光滑性。
描述符的演进:从局部坐标架到注意力
第一版 local frame descriptor 用最近两个原子构造旋转矩阵,把相对坐标变换到原子自身坐标系,输出 1/r 与三个方向余弦。它的问题很具体:在截断半径处不光滑,最近邻交换顺序时也会跳变,因此作者明确建议常规体系改用其他描述符。DeepPot-SE 的 two-body embedding 用五阶多项式 switching function s(r) 把 1/r 在 r_s 到 r_c 之间光滑压到零,使 descriptor 二阶导数连续;embedding network 只输入 s(r_ij),再与坐标矩阵做 G^T R R^T G_< 的组合,因此虽名为 two-body,表达的却是多体信息。three-body embedding 进一步把邻居间夹角 θ_jk 送入 embedding network,理论上包含更多信息。多元素体系默认按元素分别设 embedding network,参数量随元素数平方增长,例如 OC2M 的 57 种元素会带来 3249 个网络,显存与效率都吃紧。type embedding 把原子类型 one-hot 后过一个神经网络,作为额外输入注入 embedding 与 fitting network,让所有元素共享参数,这是多元素体系可扩展的关键。attention-based descriptor(DPA-1)在 embedding 矩阵上叠加 self-attention,query、key、value 由线性变换得到,注意力权重在 softmax(QK^T/√d_k) 之外乘以归一化相对坐标的外积以引入角度信息,再以残差加 LayerNorm 的方式堆叠 L_a 层。hybrid descriptor 则把多个同类或不同类 descriptor 拼接,允许对不同分支设置不同截断半径。
拟合网络:能量、力、virial 与张量性质
fitting network 输出标量即原子势能 E_i,力与 virial 由 autograd 对坐标和模拟盒基矢量求导得到,因此模型天然保守。框架还支持把原子级或帧级参数(例如电子温度)作为额外输入,用于 warm dense matter 一类场景。张量性质走的是等变构造:一阶张量(dipole)由 embedding 矩阵与坐标矩阵线性组合,二阶张量(polarizability)再乘一层坐标矩阵,由此可以计算 IR 与 Raman 谱。
光滑性与保守性
switching function 采用五阶多项式,保证函数值、一阶与二阶导数在两端连续;力与 virial 由能量解析求导,避免非保守力造成的能量漂移。
可组合性
descriptor、fitting network、modifier 都是 Python 类,可拼接成 hybrid descriptor,也可通过插件系统扩展,无需改动主包代码。
长程静电、范围校正与短程外推
纯局域 descriptor 的短板是长程与非键合中程相互作用。DPRc 的设计思路是 Δ-MLP 式的范围校正:把 switching function 修改为当 i 与 j 同属 MM 区域时取零,从而保证 MM-MM 之间不产生力;同时把 MM 原子的能量偏置减去 F_0(0),使 MM 原子进出 QM 区域邻域时能量守恒。这样 DPRc 只负责 6 Å 量级的中短程修正,长程静电仍由 particle mesh Ewald 及其多极与 QM/MM 扩展高效处理,可以直接挂在用 non-bonded list 的 MD 软件里。该框架后来还扩展到类药分子的 QDπ 模型,在互变异构与质子化状态上优于其他半经验方法与纯 MLP。
DPLR 则把静电能显式加进总能量:E = E_DP + E_ele,其中短程部分拟合 E* − E_ele,长程部分用一组高斯分布近似电子结构,在 Fourier 空间用 Ewald 型求和计算,电荷包括离子电荷与由 dipole 模型得到的 Wannier centroid,可调参数 β 控制高斯展宽,L 是 Fourier 截断。作者证明高斯近似带来的误差由按 r 的负四次方衰减的偶极-四极相互作用主导。
短程外推与插值:辐射损伤等场景中两核距离可能近到 DFT 无法收敛,此时 DP 模型会与经验 pair potential(如 Ziegler-Biersack-Littmark 屏蔽核排斥势)按权重 w_i 平滑插值。权重由原子到邻居距离的 softmin σ_i 决定,在 [r_a, r_b] 区间用同样的五阶多项式完成切换,保证能量与力连续。
modifier 这一层的设计让上述能力都以可插拔方式接入同一条推理链路:DPLR、pairwise 插值、以及其他自定义修正共用同一套 API,这也是 DeePMD-kit 能与 AMBER、LAMMPS 等软件中既有的长程求解器复用的原因。
训练策略与 model deviation 驱动的并发学习
Trainer 侧的定义与模型同样模块化。学习率按指数衰减到 γ_stop;loss 是各拟合性质损失的加权和,权重随训练进度在 p_start 与 p_limit 之间线性退火;能量、力、virial、相对能量 ΔE 的 MSE 都按原子数归一化,使不同体系可比。针对自由能剖面或动力学同位素效应等只关心部分原子的场景,可给原子力损失加系数 q_k;针对高温反应体系中力可达 60 eV/Å 以上的场景,可改用相对于力幅值的损失,让小的力也被拟合好。优化器为 Adam,训练步数通常设为数百万。multi-task training 让多个数据集共享同一 descriptor,各自保留 fitting network,从而在同一模型里容纳不同交换关联泛函或基组的数据。
model deviation:把不确定性变成采样信号
用同一数据集、独立初始化训练一组 n_m 个模型,其预测的标准差即 model deviation,支持原子力 ε_F,i 与 virial ε_Ξ,αβ,也可用相对形式避免大幅值下误报。ε 小说明数据已被学到,ε 大说明该构型未被覆盖,需要补充训练数据。实践中一帧内力的最大 model deviation ε_F,max 被证明是并发学习或主动学习中最好的误差指标。
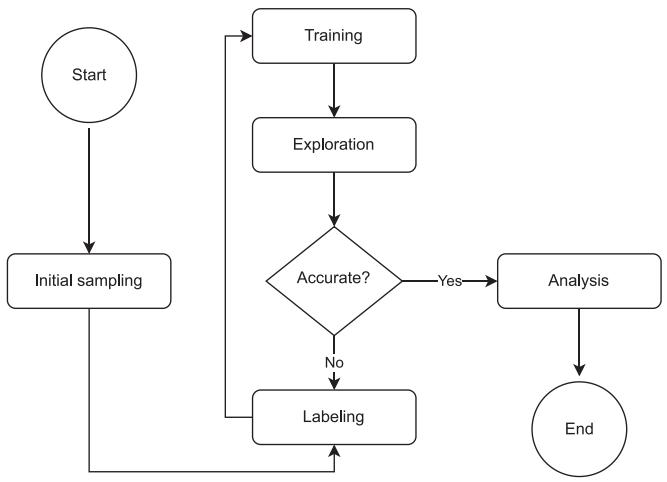
这套机制的意义在于把模型误差从事后验证变成在线信号:exploration 阶段 on-the-fly 计算 model deviation,非平衡过程的模拟时长还能随轮次逐步增加,从而在已知与未知化学空间之间自动扩展训练集。
技术实现:代码架构、GPU 算子、MPI 与模型压缩
DeePMD-kit 用 TensorFlow 计算图组织模型,关键算子用 C++ 手写,包括原子环境矩阵、邻居表、Ewald 求和、压缩网络及其反向传播,力与 virial 依赖 TensorFlow 的 autograd 对坐标与盒张量求导。核心 C++ 库可脱离 TensorFlow 独立构建与测试;GPU 库(CUDA 或 ROCm)是核心库的可选部分;DP operators 库补齐 TensorFlow 不提供的自定义算子;model definition 模块用 Python 生成可保存与恢复的计算图;推理侧提供 Python、C++、C 与 header-only C++ 四套 API,其中 C API 的 ABI 更稳定,便于与 AMBER 这类成熟软件集成;CLI 同时服务训练与推理。构建用 CMake,分发用 pip 与 scikit-build,测试用 Python unittest 与 GoogleTest,GitHub Actions 负责持续集成。
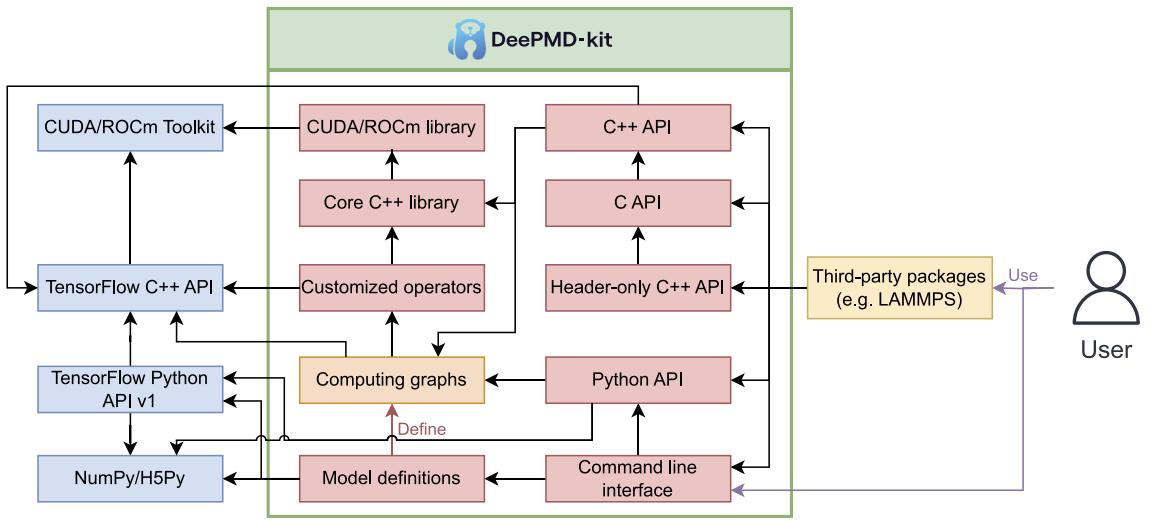
性能:从排序技巧到压缩与非冯诺依曼架构
环境矩阵算子分两步:格式化邻居表与计算 R 矩阵元素。为了在 GPU 上加速排序,原子类型、距离与索引被打包进一个 64 位整数 S = α_j × 10^15 + floor(r_ij × 10^8) × 10^5 + j,排序后再解压,避免多字段比较。多设备训练借助 Horovod 的数据并行,按 batch 维度切分数据,只在进程间平均可训练参数的梯度,从而规避 batch 尺寸与张量形状冲突并减少通信量,mpi4py 用于去除冗余日志。多设备 MD 则复用第三方软件自身的并行能力:LAMMPS 的域分解与邻居表、AMBER 接口中的邻居表,DeePMD-kit 接受外部传入的 n(i) 替代自带邻居计算,来自其他设备的邻居作为 ghost 原子不贡献该设备的原子能量。
模型压缩的三招
- 表格化推理:输入为一维的 embedding network 用分段五阶多项式替代,系数由函数值与一阶、二阶导数解析给出。
- 算子融合:G 矩阵一旦算出一列就立即在寄存器中与环境矩阵行相乘,避免张量在 host 与 device 之间搬运。
- 精确邻居索引:在表格化阶段就按真实邻居数索引,省掉与补零零的乘法。
NVNMD:绕开内存墙
- DP 模型推理占 MD 时间与能耗的 95% 以上,其中九成以上耗在处理器与内存之间的数据搬运。
- 非冯诺依曼架构芯片把模型参数常驻片上存储,硬件算法全流水线执行。
- 结果是精度不变而效率提升,基准中比常规 MD 快 50 至 100 倍。
易用性方面同样做了大量工程:Sphinx 与 Doxygen 从 docstring 生成文档,DArgs 自动生成参数文档并校验用户输入,文档托管在 Read the Docs,GitHub Discussion 提供问答;安装提供 pip、Conda(DeepModeling 与 conda-forge 通道)、Docker 与离线包,覆盖 Linux、macOS 与 Windows,并附带 LAMMPS 插件、i-PI driver 与 GROMACS patch;输入用 JSON 或 YAML,DP-GUI 可在网页上填参数并导出;自动 batch size、自动邻居数 N_c 与自动 system 概率降低了新手门槛;训练数据支持 NumPy 二进制与 HDF5 两种格式,由 DP-Data 从各类电子结构软件输出转换而来;可视化沿用 TensorBoard 的指标跟踪、计算图查看与 profiling。
基准测试:精度与效率没有免费午餐
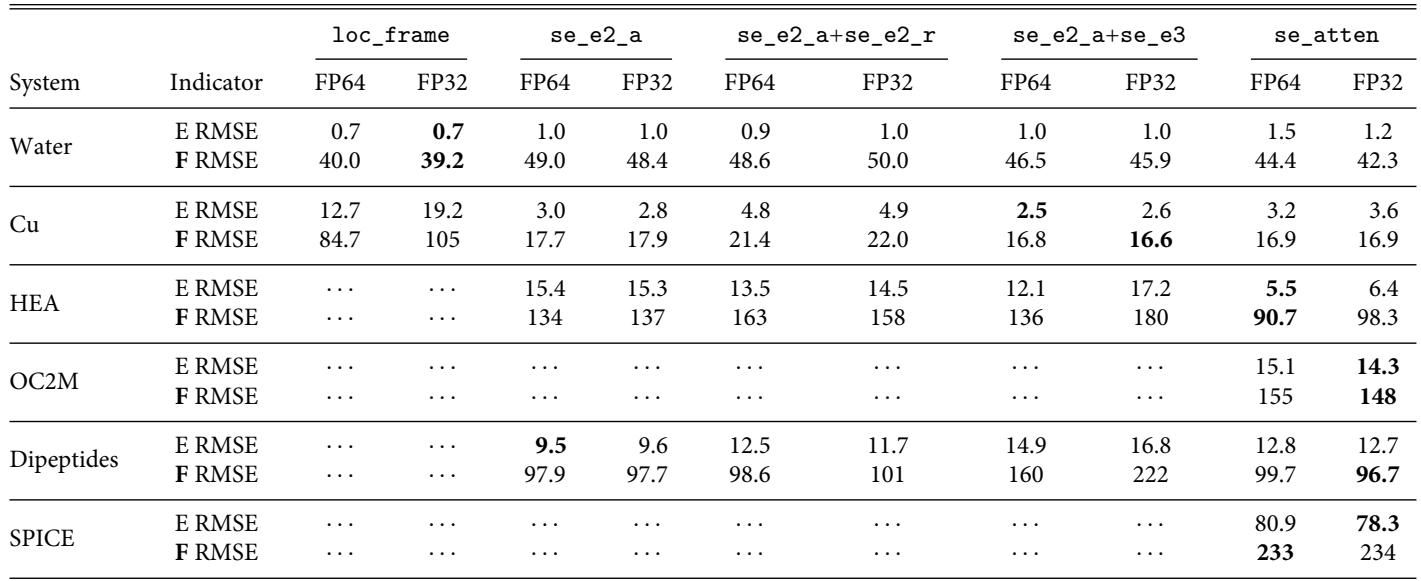
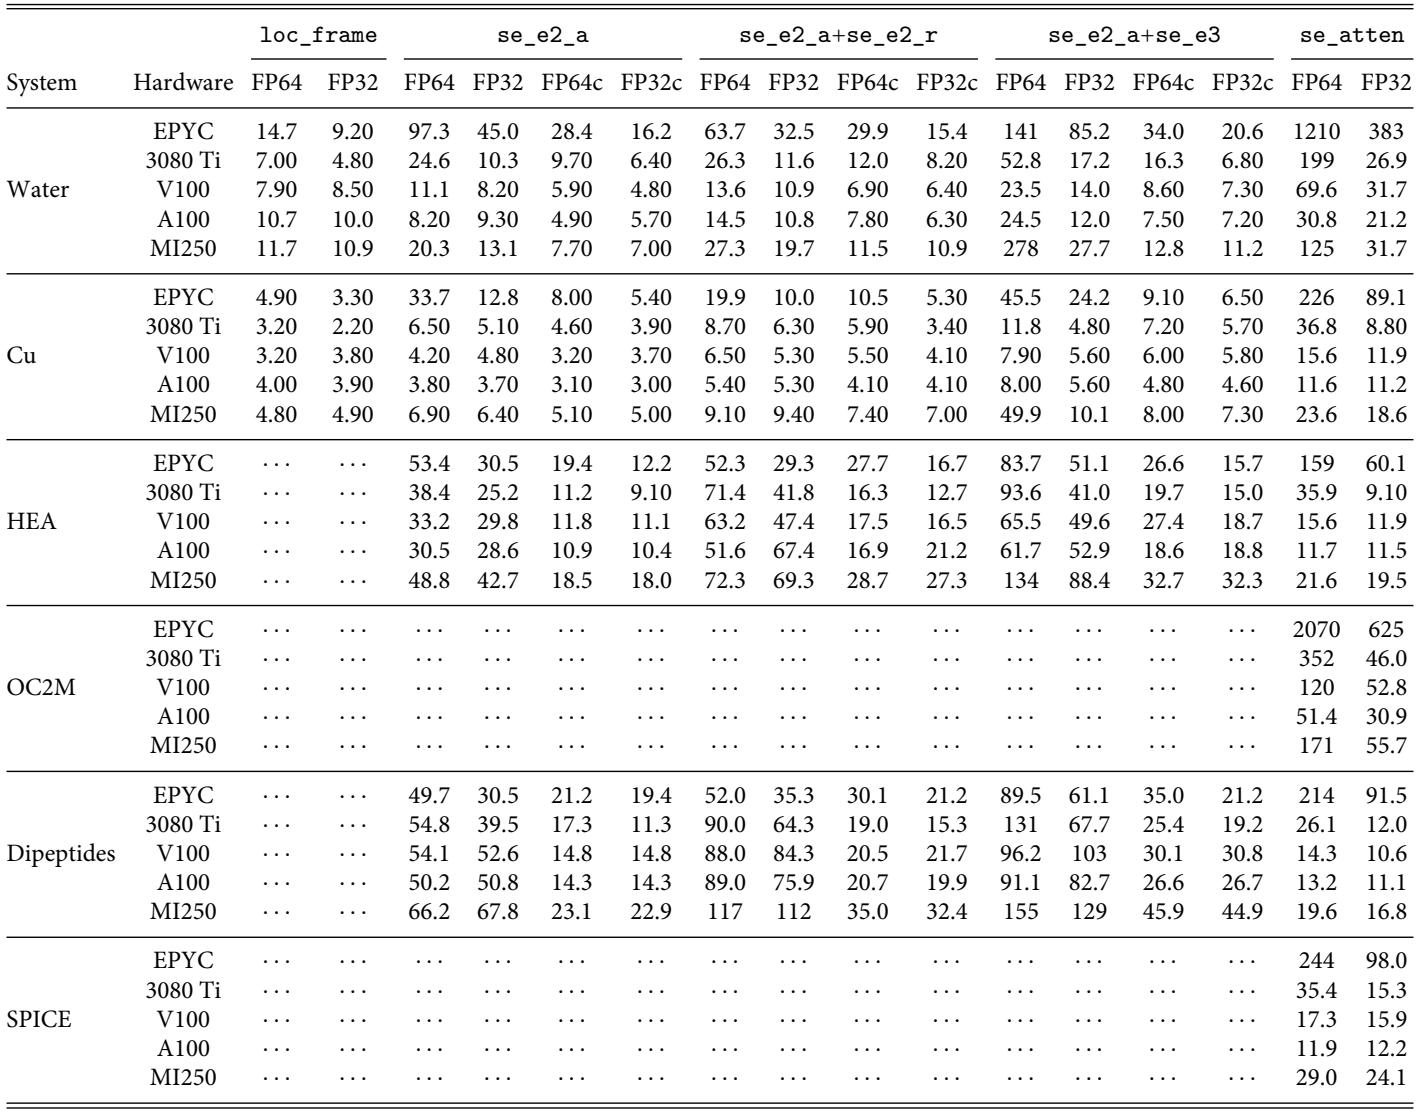
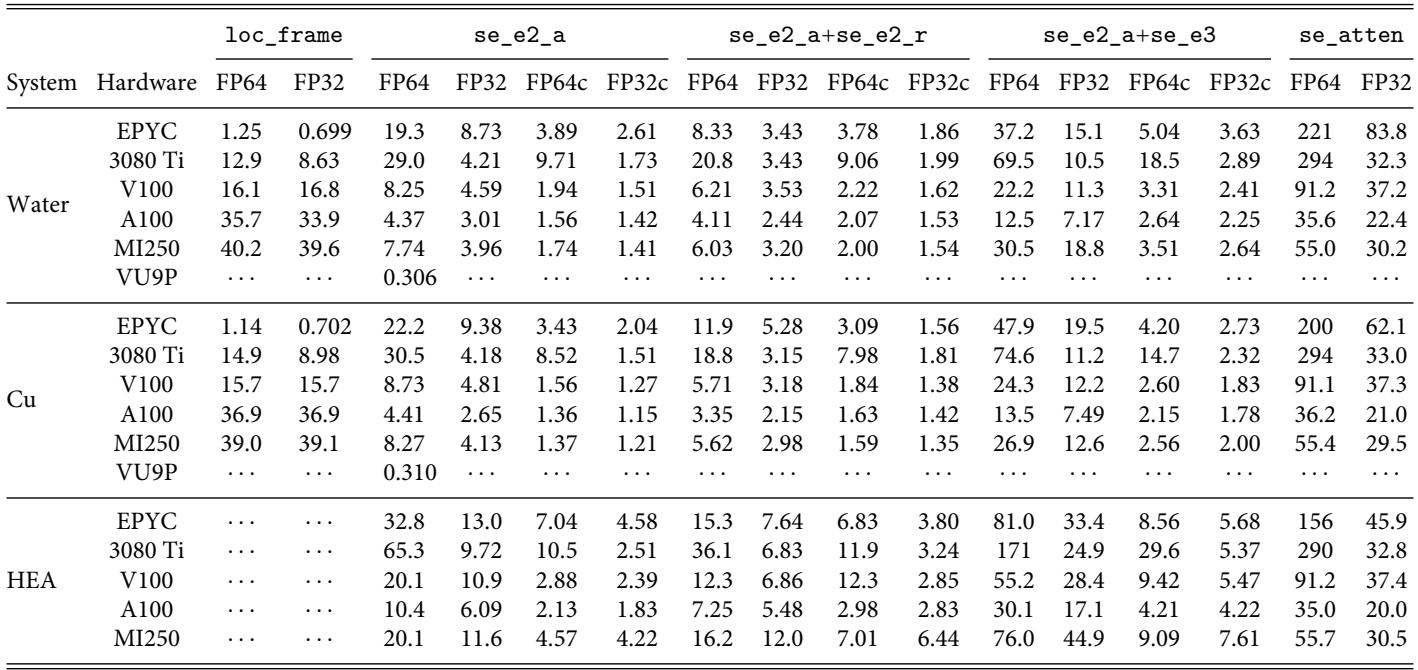
作者在六个数据集上横向比较了五种 descriptor 与 FP64/FP32 两种精度,并测试了压缩模型。数据集刻意覆盖液体、固体、气体、周期与非周期边界、宽温压范围、离子与不同质子化状态的类药分子。
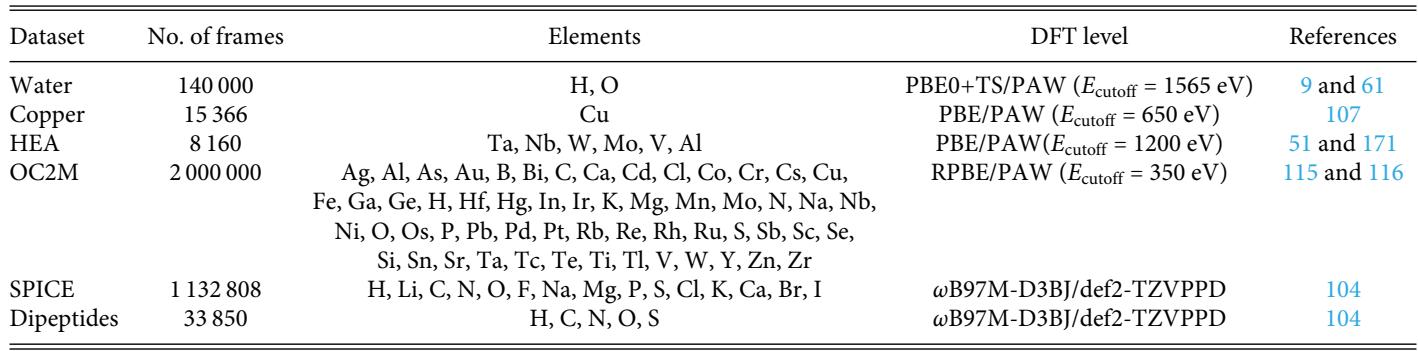
模型设置统一取 r_s = 0.5 Å、M_< = 16、L_a = 2,two-body embedding 网络为 (25, 50, 100),three-body 为 (2, 4, 8),fitting network 为 (240, 240, 240, 1);hybrid 中 full-information 分支 r_c 取 4 Å,OC2M 取 9 Å,其余取 6 Å。训练步数固定(水、Cu、dipeptides 为 100 万,HEA 为 1600 万,OC2M 与 SPICE 为 1000 万),硬件包括 128 核 AMD EPYC 7742、RTX 3080 Ti(12 GB)、Tesla V100(40 GB)、A100(80 GB)、AMD Instinct MI250 GCD,以及用于 NVNMD 的 Xilinx VU9P FPGA。
结果解读
loc_frame 在水上又准又快,但三个限制让它难以通用:不光滑、尚无 GPU 实现、要求体系具有相近的化学组成才能构造局部坐标架,因而在宽温压的 Cu 以及 HEA、OC2M、dipeptides、SPICE 上不可用。DeepPot-SE 在精度与性能的泛化上最均衡。three-body embedding 理论上信息更多,在水与 Cu 上确实更准,但在 HEA 与 dipeptides 上预期排序并不成立,作者推测是元素数增多导致可训练参数增多、固定步数下 loss 未收敛,同时网络数量增加也拖慢了速度。se_atten 因网络数少而显存占用低,才使 OC2M(60 余种元素)与 SPICE(约 20 种)这类数据集变得可行。作者特别强调:这些模型是为横向比较而训,超参未针对任何体系调优,不宜用于生产,也不宜与其他软件发表的成熟模型直接比较。
| 选型场景 | 推荐 descriptor | 理由 |
|---|---|---|
| 元素少、追求 CPU 吞吐 | loc_frame | 最快且水体系精度最高,但不光滑且无 GPU 支持 |
| 通用生产模型 | se_e2_a(可加 se_e2_r 或 se_e3) | 光滑、精度与速度均衡,支持压缩 |
| 多元素、大杂化空间 | se_atten 加 type embedding | 网络数与显存大幅下降,GPU 训练更快 |
| 极限规模与能效 | se_e2_a 压缩模型或 NVNMD | 压缩 1 至 10 倍加速,NVNMD 50 至 100 倍 |
生态、可扩展性与结论
DeePMD-kit 以 LGPL-3.0 开源,并以此为核心在 2021 年形成了 DeepModeling 社区。与它配套的包包括:实现并发学习的 DP-GEN(下一代 DP-GEN2 基于 Dflow 工作流平台)、做自由能与热力学积分及相图的 DP-Ti、做数据格式转换与可视化的 DP-Data、向 HPC 调度器提交并监控任务的 DP-Dispatcher、管理输入参数的 DArgs、以及网页图形界面 DP-GUI;社区里还有 DeePKS-kit、DMFF、ABACUS、DeePH、DeepFlame 等相关项目。
接口即能力:与主流模拟软件的集成
- LAMMPS 通过包内开发的插件无缝对接,支持 MPI、on-the-fly 计算 model deviation,并能从常量、LAMMPS 计算的电子温度或任意 compute style 获取原子级与帧级参数;DPLR 还直接复用 LAMMPS 的 Ewald 与 PPPM 的 k 空间部分。
- i-PI 通过专用 driver 支持 path integral molecular dynamics,并兼容 MDI 与 ASE 接口;由于 UNIX socket 或网络通信会限制性能,PIMD 功能也被引入 LAMMPS 与 DeePMD-kit 直接配合。
- AMBER 通过定制源码集成,支持 QM/MM 加 DPRc 的高效模拟,只对 AMBER mask 指定的 QM 区域及其 MM 缓冲层推理,支持 MPI 与并发学习,并可结合 AMBER 的 GPU 自由能引擎与间接 MM 到 QM/Δ-MLP 方法做 alchemical free energy 计算。
- OpenMM 插件支持标准 DP 模拟与 DP/MM 混合模拟,DP 区域可固定也可在模拟中自适应变化;GROMACS 通过 patch 支持 DP/MM;ABACUS 支持 C 与 C++ 接口,未来可与 KSDFT、SDFT、OFDFT 等方法组合。
当前边界:附录 B 列出不支持 GPU 的功能,包括 local frame descriptor、与 pair potential 的插值、从数据中统计 N_c、model deviation、NVNMD 专有功能以及 LAMMPS 插件中 DPLR 的 KSpace 求解器;模型压缩目前只支持 se_e2_a、se_e2_r 与 se_e3,se_atten 的压缩仍在开发;NVNMD 目前只支持不超过四种元素、FP64 的常规 se_e2_a。
总结来看,这篇软件文章的价值不只在算法本身,而在于把 Deep Potential 这一类 MLP 做成了一条可复用、可扩展、可部署的工程链路:模型以 Python 模块组织并编译为计算图,自定义算子针对硬件优化,API 覆盖 Python 到 C,训练与不确定性估计闭环由 model deviation 与并发学习提供,精度与效率的权衡则由公开的基准数据支撑。作者明确表示希望社区继续贡献,把这一平台扩展到更多计算科学场景。
[精选]参考文献
- L. Zhang, J. Han, H. Wang, R. Car, and W. E. “Deep potential molecular dynamics: A scalable model with the accuracy of quantum mechanics.” Phys. Rev. Lett. 120, 143001 (2018).
- H. Wang, L. Zhang, J. Han, and W. E. “DeePMD-kit: A deep learning package for many-body potential energy representation and molecular dynamics.” Comput. Phys. Commun. 228, 178–184 (2018).
- L. Zhang, H. Wang, M. C. Muniz, A. Z. Panagiotopoulos, R. Car, and W. E. “A deep potential model with long-range electrostatic interactions.” J. Chem. Phys. 156, 124107 (2022).
- J. Zeng, T. J. Giese, Ş. Ekesan, and D. M. York. “Development of range-corrected deep learning potentials for fast, accurate quantum mechanical/molecular mechanical simulations of chemical reactions in solution.” J. Chem. Theory Comput. 17, 6993–7009 (2021).
- D. Lu, W. Jiang, Y. Chen, L. Zhang, W. Jia, H. Wang, and M. Chen. “DP compress: A model compression scheme for generating efficient deep potential models.” J. Chem. Theory Comput. 18, 5559–5567 (2022).
- P. Mo, C. Li, D. Zhao, Y. Zhang, M. Shi, J. Li, and J. Liu. “Accurate and efficient molecular dynamics based on machine learning and non von Neumann architecture.” npj Comput. Mater. 8, 107 (2022).
- Y. Zhang, H. Wang, W. Chen, J. Zeng, L. Zhang, W. Han, and W. E. “DP-GEN: A concurrent learning platform for the generation of reliable deep learning based potential energy models.” Comput. Phys. Commun. 253, 107206 (2020).
- D. Zhang, H. Bi, F.-Z. Dai, W. Jiang, L. Zhang, and H. Wang. “DPA-1: Pretraining of attention-based deep potential model for molecular simulation.” arXiv:2208.08236 (2022).
补充说明:完整参考文献共 176 条,详见原文。代码托管于 https://github.com/deepmodeling/deepmd-kit,本文基准数据与脚本见 https://github.com/deepmodeling-activity/deepmd-kit-v2-paper。